Als Beispiel für supervised learning schauen wir uns den ML-Algorithmus k-nearest-neighbors an.
Problem
Pilzsammler Heinz-Wilhelm kommt vom Pilzsammeln aus dem Böhmerwald nach Hause. Er hat 14 Stück gefunden und möchte diese überprüfen lassen. Also bringt er sie zum Pilzkontrolleur nach Bad Leonfelden. Dieser schaut sich die Pilze an und findet unter den 14 Exemplaren 7 essbare Wiesenchampignons, 6 giftige Karbolchampignons und sogar einen tödlichen Grünen Knollenblätterpilz!
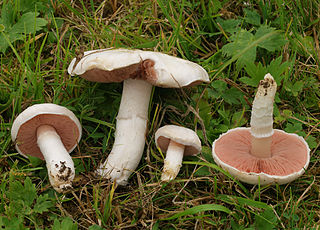
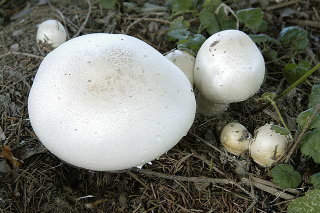
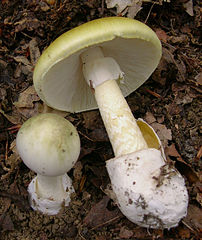
Heinz-Wilhelm möchte nicht immer zum Kontrolleur und informiert sich, wie man die Pilze voneinander unterscheiden kann: Sie unterscheiden sich primär in der Farbe der Lamellen. Weitere Merkmale sind Fleischverfärbungen und Geruchsunterschiede.
Heinz-Wilhelm macht sich an die Arbeit und baut ein Pilzsortiermaschine.
Merkmale
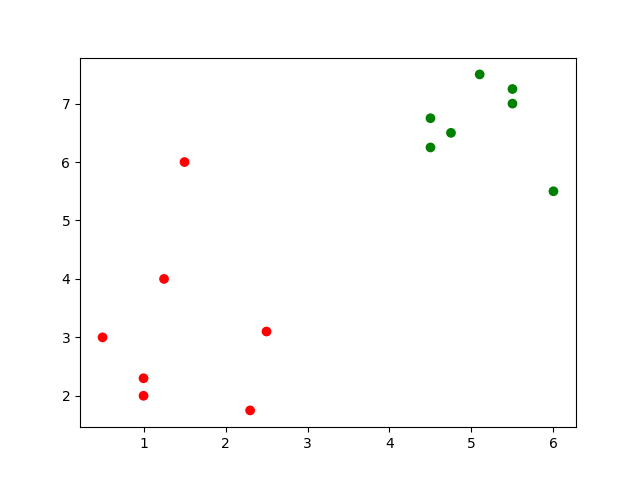
Die Sortiermaschine, die Heinz-Wilhelm gebaut hat, untersucht die Farbe der Lamellen und die Fleischverfärbung und liefert zwei Zahlenwerte zurück. Heinz-Wilhelm erhält für die 14 kontrollierten Pilze die folgenden Werte:
| Pilz | Lamellen | Fleisch | Sorte | Geniessbarkeit |
|---|---|---|---|---|
| A | 1 | 2 | Karbolchampignon | giftig |
| B | 0.5 | 3 | Karbolchampignon | giftig |
| C | 1.25 | 4 | Karbolchampignon | giftig |
| D | 2.3 | 1.75 | Karbolchampignon | giftig |
| E | 1 | 2.3 | Karbolchampignon | giftig |
| F | 2.5 | 3.1 | Karbolchampignon | giftig |
| G | 1.5 | 6 | Knollenblätter | giftig |
| H | 5.5 | 7 | Wiesenchampignons | essbar |
| I | 6 | 5.5 | Wiesenchampignons | essbar |
| J | 5.5 | 7.25 | Wiesenchampignons | essbar |
| K | 4.5 | 6.75 | Wiesenchampignons | essbar |
| L | 4.5 | 6.25 | Wiesenchampignons | essbar |
| M | 4.75 | 6.5 | Wiesenchampignons | essbar |
| N | 5.1 | 7.5 | Wiesenchampignons | essbar |
Heinz-Wilhelm zeichnet die gemessenen Werte in einem Koordinatensystem auf. Er markiert die essbaren Champignons mit grüner Farbe und die ungeniessbaren und giftigen Pilze mit roter Farbe.
Aufgabe
Können anhand dieser Merkmale die Pilze gut dem richtigen Typ zugeordnet werden?
Visualisierung
Jeder Pilz kann als Punkt in einem Koordinatensystem dargestellt werden. Dabei ist die
Diese Methode funktioniert auch, wenn mehr als zwei Merkmale gemessen werden. Bei
Die Daten können bequem in Excel visualisiert werden. In der untenstehenden Excel-Datei können die Daten der Pilze auf dem Arbeitsblatt «Klassifikation» oder «Training Dateneingabe» erfasst werden.
Sie werden automatisch im Diagramm auf dem Arbeitsblatt «Klassifikation» dargestellt.
Es liegen zwei Varianten vor: In der oberen Variante werden die Pilze nach essbar/nicht essbar klassifiziert, in der unteren nach ihrer Sorte.
Anwendung
Die oben genannten Punkte stellen unsere Trainingsdaten dar. Was geschieht jetzt, wenn wir einen neuen Punkt erhalten? Wie kann dieser möglichst klar einer der beiden Kategorien zugeordnet werden?
Aufgabe: neue Pilze
Er findet zwei weitere Pilze und misst diese: Kannst du die Werte für Heinz-Wilhelm hinzufügen und blau darstellen?
| Pilz | Lamellen | Fleisch | Sorte | Geniessbarkeit |
|---|---|---|---|---|
| X | 2 | 3 | ?? | ?? |
| Y | 3.5 | 4.5 | ?? | ?? |
Zu welcher Kategorie würdest du die neuen Pilze zählen? geniessbar oder giftig?
im Arbeitsblatt «Klassifikation» können unter «Neuer Datensatz» die Daten eines neuen Pilzes eingegeben werden. Dieser wird im Diagramm gelb dargestellt.
k-nearest-neighbors
Der k-nearest-neighbors-Algorithmus ist ein Klassifikationsalgorithmus. Er kann für Probleme wie z.B. die Klassifikation der beiden neuen Pilze bei Heinz-Wilhelm eingesetzt werden.
Definition: k-nearest-neighbors
Der k-nearest-neighbors-Algorithmus klassifiziert einen neuen Datensatz
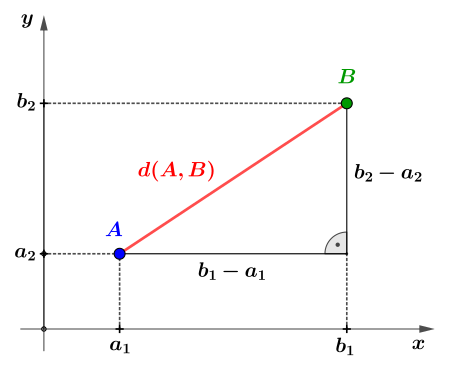
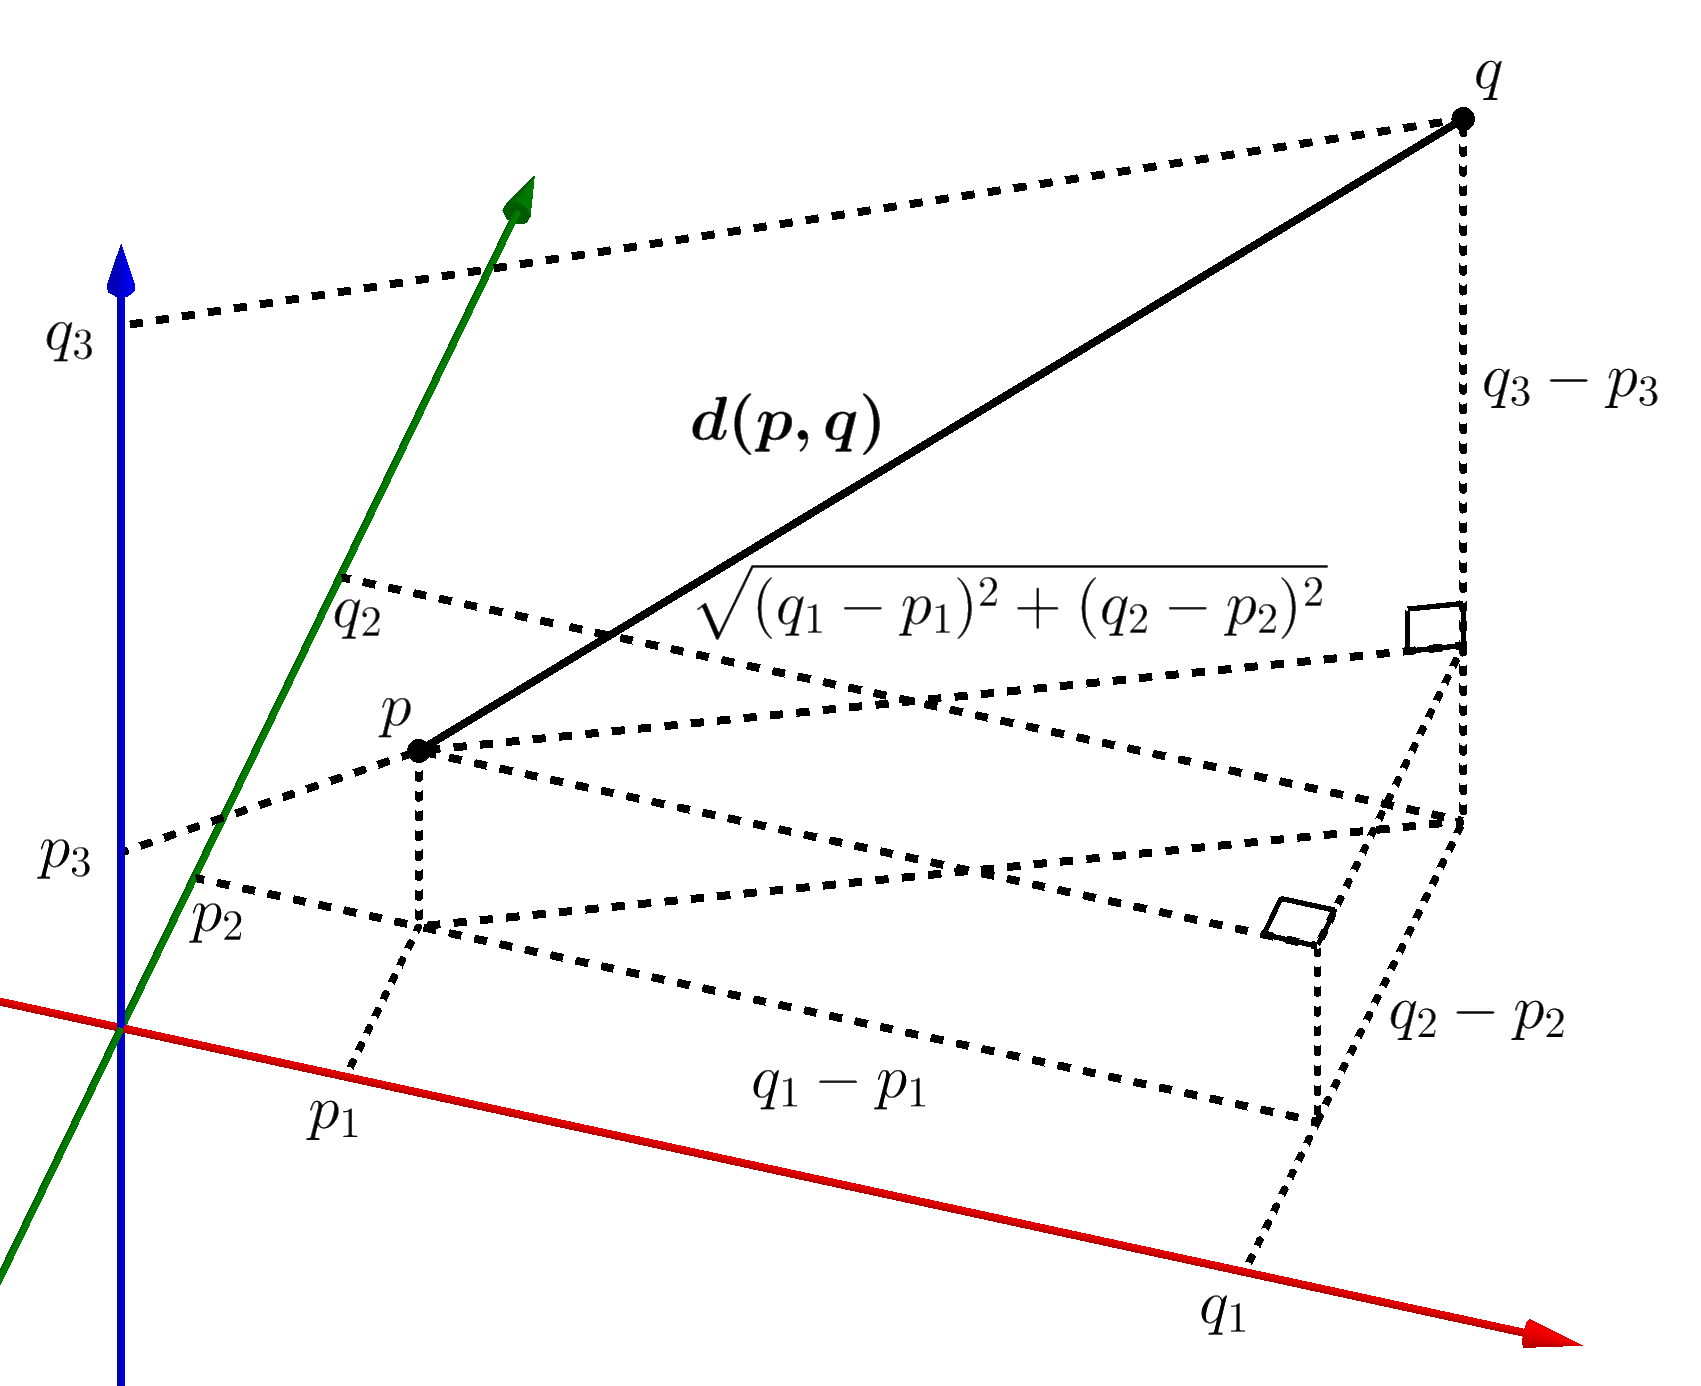
Als Abstand wird üblicherweise der euklidische Abstand verwendet. D.h. der Abstand zwischen dem Datensatz
Die Kategorie von
Lösung: Abstand berechnen
In der Ebene geht das einfach mit Pythagoras:
Dieser sogenannte Euklidische Abstand lässt sich auch im Raum berechnen:
Aufgabe: Klassifizierung
In Excel wird die Klassifizierung automatisch gemacht. Unter «Berechnung ganzer Datensatz» werden die Abstände aller Trainingsdaten zum neuen Datensatz berechnet und diese aufsteigend nummeriert (Rang).
Bestimmung des Parameters k – Allgemein[4]
Der Hyperparameter
Datenpunkts für die Klassifikation – also die Einordnung in eine Klasse –
herangezogen werden. Die Wahl von
k-nächste-Nachbarn-Algorithmus. Der passende Wert wird in der Regel nicht zufällig
gewählt, sondern anhand von Validierungsdaten bestimmt.
Definition: Verfahren kurz gefasst
Die Validierungsdatenpunkte werden der Reihe nach für verschiedene Werte von
mit Hilfe der Trainingsdaten klassifiziert. Danach wird geprüft, für welche Werte
von
wurde. Dieses Vorgehen wird für alle Validierungsdaten sukzessive durchgeführt.
Die Werte für
haben, sind unsere Kandidaten für den Parameter
Situation
In der Tabelle Bestimmung k_Allgemein der Excel-Arbeitsmappe werden die
eingegebenen Trainingsdaten automatisch in Trainings- und Validierungsdaten
aufgeteilt. Die aufgeteilten Daten werden links in den jeweiligen Bereichen
angezeigt.
Vorgehen
Auswahl des aktuellen Validierungsdatenpunkts:
Wähle einen Validierungsdatenpunkt aus den Validierungsdaten aus und trage
ihn beim «Aktuellen Validierungsdatenpunkt» ein. Dabei müssen lediglich die
Werte für die Merkmale Lamellen und Fleisch eingetragen werden. Wird der
eingetragene Datenpunkt in den Validierungsdaten gefunden, wird das erwartete
Label automatisch übernommen und der entsprechende Punkt hervorgehoben.Ablesen der Klassifikation für verschiedene Werte von k:
Die Tabelle klassifiziert den eingetragenen Validierungsdatenpunkt automatisch
fürund vergleicht das berechnete Label mit dem erwarteten
Label des Datenpunkts. Direkt angezeigt wird auch, ob die Klassifikation für
einen Wert vonkorrekt war – ob also das berechnete Label mit dem
erwarteten Label übereinstimmt.Die Einträge im Bereich «Label k-ter Nachbar» stellen das Label des jeweils
-ten Nachbarn des betrachteten Validierungsdatenpunkts dar. So ist
nachvollziehbar, wie das Modell auf die Klassifikation für den jeweiligen Wert
vonkommt. Aufgabe
Welches Ergebnis liefert die Tabelle für den Pilz mit den Werten (4.5, 6.75)?
Für welche Werte vonwurde er korrekt klassifiziert? Eintragen des Klassifikationsergebnisses:
Trage im Bereich «Bestimmung eines passenden Werts k» für jene Werte von
ein X ein, für die die Klassifikation korrekt war. Führe dieses Vorgehen für
alle Validierungsdatenpunkte durch.Ablesen der besten Werte für k:
In der Zeile «Korrekt» wird prozentual dargestellt, wie viele
Validierungsdatenpunkte für die jeweiligen Werte vonkorrekt vorhergesagt
wurden. Die Werte vonmit dem höchsten Prozentsatz sind unsere Kandidaten
für.
Hinweis
Im rechten, oberen Bereich der Tabelle werden Informationen zu den 10 nächsten
Nachbarn des aktuell betrachteten Validierungsdatenpunkts angezeigt. Diese dienen
lediglich der zusätzlichen Information und haben keine direkte Bedeutung für die
Bestimmung der Kandidaten für den Parameter
Testen des trainierten Modells (Konfusionsmatrix)[5]
Nachdem ein Modell mit maschinellen Lernen trainiert wurde, muss die Güte des
Modells geprüft werden, bevor es eingesetzt werden kann. Das Testen ist neben
dem Training der zweite große Bestandteil des maschinellen Lernprozesses.
Definition: Verfahren kurz gefasst
Eine Menge an Testdaten wird mit Hilfe des trainierten Modells klassifiziert und
die erwarteten Label der Testdaten werden mit den vom Modell berechneten Label
verglichen. Die Ergebnisse dieser Vergleiche lassen sich in Form einer
Konfusionsmatrix übersichtlich darstellen.
Aus der Konfusionsmatrix kann die Genauigkeit (accuracy) des Modells berechnet
werden: Die Anzahl der korrekt klassifizierten Testdaten, dividiert durch die
Anzahl aller Testdaten.
Situation
In der Tabelle Testen_Konfusionsmatrix werden links die Testdaten angezeigt.
Diese kannst du beliebig verändern. Achte dabei aber darauf, dass du als
erwartetes Label nur Label aus den bei den Trainingsdaten zugelassenen Label
verwendest (Karbolchampignon, Knollenblaetter, Wiesenchampignon).
Vorgehen
Eingabe des Parameters k:
Gib neben der Zelle «Parameter k» den gewünschten Wert fürein. Es werden
nur ganzzahlige Werte von 1 bis 10 unterstützt.Auswahl des aktuellen Testdatenpunkts:
Wähle einen Testdatenpunkt aus den Testdaten aus und trage ihn beim «Aktuellen
Testdatensatz» ein. Dabei müssen lediglich die Werte für die Merkmale
Lamellen und Fleisch eingetragen werden. Wird der Testdatenpunkt in den
Testdaten gefunden, wird das erwartete Label automatisch übernommen und der
entsprechende Datenpunkt hervorgehoben.Vergleich berechnetes Label – erwartetes Label und Eintragung in die Konfusionsmatrix:
Vergleiche den Eintrag neben «Berechnetes Label» mit dem Eintrag neben
«Erwartetes Label». Erhöhe den zugehörigen Eintrag in der Konfusionsmatrix
um 1 – die Zelle ergibt sich aus dem erwarteten Label (Zeile) und dem
berechneten Label (Spalte).Führe dieses Vorgehen für alle Testdatenpunkte durch.
Ablesen der Genauigkeit:
Die Genauigkeit des trainierten Modells für die Testdaten wird automatisch
berechnet und in der Zelle «Genauigkeit» angezeigt.
Hinweis
Im rechten Bereich der Tabelle werden zusätzliche Informationen zu den
Trainingsdaten, den zum aktuellen Testdatenpunkt
eine graphische Darstellung der
das Testen nicht direkt notwendig und dienen nur der zusätzlichen Information.
Aufgabe
Teste das Modell mit den beiden neuen Pilzen (2, 3) und (3.5, 4.5) für
Diagonale der Konfusionsmatrix bedeuten?
Weitere Beispiele
Andreas Kunze via Wikimedia Commons (CC BY-SA 3.0) ↩︎
James Lindsey at Ecology of Commanster via Wikimedia Commons (CC BY-SA 2.5) ↩︎
Ak ccm via Wikimedia Commons (CC BY-SA 3.0) ↩︎
Didaktik der Informatik, Universität Passau ↩︎
Didaktik der Informatik, Universität Passau ↩︎